El español que se habla en México no es el mismo que se habla en Argentina, Colombia o Chile. Para un agente de IA conversacional de cobranza, no entender estas variaciones significa tasas de contacto efectivo pobres, frustración del usuario y pérdida de oportunidades de recuperación.
Por qué el español de LATAM es un desafío único para la IA
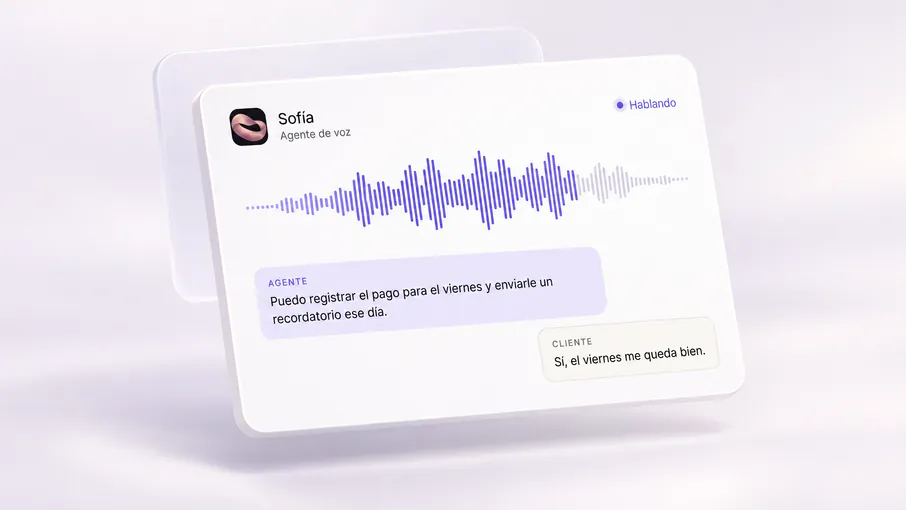
La mayoría de los modelos de reconocimiento de voz (ASR) y procesamiento de lenguaje natural (NLP) están entrenados primordialmente con español de España o inglés. Esto crea problemas serios cuando se aplican en Latinoamérica:
Diferencias fonéticas significativas
- Seseo vs distinción: en LATAM no se distingue entre 's', 'c' y 'z', todas suenan como 's'
- Yeísmo: 'll' y 'y' se pronuncian igual (en España pueden diferenciarse)
- Aspiración de 's' final: muy común en Caribe (Cuba, Rep. Dominicana, Puerto Rico, costa de Colombia y Venezuela)
- Pronunciación de 'r' y 'rr': varía dramáticamente entre México, Argentina y Costa Rica
- Elisión de consonantes: en algunos dialectos caribeños, "pescado" suena como "pecao"
Variaciones léxicas y semánticas
La misma palabra tiene significados completamente diferentes según el país:
- "Plata" = dinero en Argentina/Uruguay/Chile, pero solo el metal en México
- "Ahorita" = inmediatamente en algunos contextos, "en algún momento indefinido" en otros
- "Pagar" vs "abonar" vs "cancelar" tienen matices diferentes según el país
- Vocabulario de cobranza específico: "cuota", "dividendo", "parcialidad" se usan de forma distinta
Velocidad y ritmo de habla
- Caribeños: hablan muy rápido y con muchas elisiones (200-220 palabras/minuto)
- Mexicanos del norte: ritmo moderado, articulación clara (160-180 ppm)
- Andinos: ritmo más lento, pronunciación más marcada (140-160 ppm)
Un modelo ASR entrenado solo con español neutro puede tener 40-60% de tasa de error con hablantes caribeños rápidos.
El proceso de entrenamiento: de datos a producción
Entrenar un agente IA para dialectos latinoamericanos es un proceso de múltiples etapas que requiere expertise lingüístico, técnico y del dominio específico (cobranza en este caso).
Etapa 1: Recolección de datos dialectales
La base de todo modelo de IA son los datos de entrenamiento. Para voice agents de cobranza en LATAM se necesitan:
Audio etiquetado por dialecto
- Grabaciones reales: conversaciones auténticas de cobranza en cada país objetivo
- Diversidad demográfica: hombres y mujeres, diferentes edades, niveles socioeconómicos
- Contextos variados: líneas fijas, móviles, ambientes ruidosos, conexiones de baja calidad
- Volumen mínimo: al menos 100-200 horas de audio por dialecto principal para resultados aceptables
Transcripciones y etiquetado
Cada audio necesita:
- Transcripción palabra por palabra: lo que realmente dijo el hablante
- Etiquetas de intención: qué quiso decir (promesa de pago, objeción, solicitud de prórroga)
- Etiquetas de emoción: frustración, confusión, disposición a pagar
- Metadata: país, región, edad aproximada, contexto de la deuda
Etapa 2: Fine-tuning de modelos ASR (reconocimiento de voz)
Los modelos base de reconocimiento de voz pueden adaptarse al español latinoamericano mediante:
Adaptación fonética por región
Se ajustan los modelos acústicos para reconocer variaciones:
- Modelos específicos para Caribe: entrenados para aspiración de 's', elisión de 'd' intervocálica
- Modelos para Río de la Plata: reconocimiento del "sh" característico argentino/uruguayo
- Modelos para Andes: adaptados al ritmo más lento y vocalización clara
Diccionarios y modelos de lenguaje localizados
- Vocabulario de cobranza por país: "cuota" vs "parcialidad" vs "dividendo"
- Nombres y apellidos comunes: "García", "Hernández", "Da Silva" se reconocen correctamente
- Expresiones idiomáticas: "ahorita", "al tiro", "de una", "ya mero"
Etapa 3: Entrenamiento de NLU (comprensión del lenguaje)
Reconocer las palabras es solo el primer paso; el agente debe entender qué significan en contexto.
Detección de intenciones por dialecto
La misma intención se expresa diferente en cada país:
IntenciónMéxicoArgentinaColombia
Promesa de pago"Ahorita le pago""Ya te transfiero""Ya le consigno"
No puede pagar"No tengo varo""No tengo un mango""No tengo plata"
Pedir prórroga"¿Me dan chance?""¿Me dan un tiempito?""¿Me dan una espera?"
Confirmar pago"Sale, va""Dale, listo""Listo, ya"
El modelo NLU debe entrenarse con ejemplos de cada variante para detectar correctamente la intención independientemente de cómo se exprese.
Manejo de ambigüedad y contexto
Muchas palabras son ambiguas sin contexto:
- "Ahorita" puede significar "ya mismo" o "en algún momento" dependiendo del país y tono
- "Mañana" puede ser literal o una forma cortés de decir "nunca"
- "Sí, sí" repetido puede indicar impaciencia o genuino acuerdo
Los modelos avanzados usan historial de conversación, perfil del deudor y análisis de tono para desambiguar.
Etapa 4: Generación de respuestas naturales (NLG y TTS)
El agente no solo debe entender, sino responder de forma natural para cada dialecto.
Síntesis de voz localizada
- Voces nativas por país: acento mexicano para México, argentino para Argentina
- Velocidad adaptada: más rápido en Caribe, más pausado en Andes
- Entonación apropiada: las preguntas tienen entonación diferente en cada región
Templates de lenguaje natural por dialecto
En lugar de respuestas genéricas, el agente genera mensajes culturalmente apropiados:
- México: "¿Me podría apoyar con el pago de su cuota?"
- Argentina: "¿Podrías regularizar tu situación?"
- Colombia: "¿Podría hacer el abono pendiente?"
Desafíos técnicos específicos de LATAM
Calidad de llamadas en regiones rurales
En zonas rurales de LATAM, la calidad de conexión telefónica puede ser muy baja:
- Compresión de audio agresiva: reduce el rango de frecuencias útil para ASR
- Latencia variable: complica el timing de la conversación
- Cortes y ruido: requiere modelos robustos que puedan interpolar
Los modelos deben entrenarse con audio degradado intencionalmente para manejar estas condiciones.
Code-switching y spanglish
En zonas fronterizas (México-USA) y comunidades con alta migración, es común el cambio de código:
- "Voy a hacer el payment mañana"
- "No tengo chance para pagar ahorita"
- "¿Puedo pagarte en cash?"
Los modelos deben reconocer y procesar mezclas de español-inglés sin fallar.
Variabilidad dentro del mismo país
Países grandes como México o Colombia tienen dialectos internos muy diferentes:
- México: norteño vs chilango vs yucateco vs jaliciense
- Colombia: costeño vs rolo vs paisa vs caleño
- Argentina: porteño vs cordobés vs norteño
Un agente IA de nivel enterprise debe poder identificar automáticamente el subdialecto en los primeros segundos y adaptar su modelo.
Proceso de mejora continua: aprendizaje activo
El entrenamiento de un agente IA no termina con el deployment inicial. Los mejores sistemas implementan aprendizaje activo:
Detección de errores de reconocimiento
El sistema identifica automáticamente conversaciones donde:
- El nivel de confianza del ASR fue bajo
- El usuario tuvo que repetir múltiples veces
- La conversación se escaló a humano sin resolución
Estas conversaciones se marcan para revisión manual y reentrenamiento.
A/B testing de variantes dialectales
Se prueban diferentes formulaciones para ver cuál tiene mejor tasa de conversión:
- ¿"Podría" vs "Puede" en la solicitud de pago?
- ¿Velocidad de voz 1.0x vs 1.1x para hablantes caribeños?
- ¿Qué modismos generan más rapport en cada región?
Reentrenamiento periódico
Los dialectos evolucionan. Un sistema de producción debe:
- Reentrenar modelos cada 2-3 meses con datos nuevos
- Incorporar nuevas expresiones y modismos emergentes
- Ajustar a cambios en vocabulario de cobranza (nuevos productos financieros, regulaciones)
Para saber si tu agente IA está correctamente entrenado en dialectos LATAM, mide:
Métricas de ASR (reconocimiento)
- Word Error Rate (WER) por dialecto: mide la proporción de palabras mal reconocidas en cada dialecto.
- Tasa de "no entendí": cuántas veces el usuario debe repetir.
- Latencia de reconocimiento: tiempo desde que el usuario termina de hablar hasta que el agente responde.
Métricas de NLU (comprensión)
- Tasa de escalación a humano: llamadas que requirieron intervención humana por fallo de comprensión.
Métricas de negocio
- Tasa de resolución en primera llamada por país: debe ser consistente entre países
- CSAT (satisfacción) por dialecto: usuarios de todos los dialectos deben reportar experiencia similar
- Tasa de abandono: usuarios que cuelgan porque el agente no los entiende.
Caso de uso: el impacto de dialectos bien entrenados
Empresa de cobranza multipaís en LATAM
Una empresa de cobranza operaba en México, Colombia y Perú. Al migrar a agentes IA entrenados específicamente para cada dialecto, la resolución mejoró en los tres países.
El futuro: modelos multilingües y transferencia entre dialectos
La investigación actual en NLP está trabajando en:
- Transfer learning entre dialectos: usar lo aprendido en un dialecto para acelerar el entrenamiento en otro similar
- Modelos multilingües: agentes que pueden cambiar entre portugués brasileño y español dentro de la misma conversación (útil en fronteras)
- Generación de datos sintéticos: crear datos de entrenamiento artificiales para dialectos minoritarios
Conclusión: la especialización dialectal es crítica
En cobranza, donde cada punto porcentual de tasa de contacto efectivo representa miles o millones en recuperación, entrenar agentes IA correctamente en dialectos latinoamericanos no es un nice-to-have, es un requisito fundamental. Un agente que no entiende cómo habla tu deudor, o que suena extranjero y poco natural, pierde credibilidad y efectividad.
Para la mayoría de empresas, tiene sentido enfocarse en su core business mientras confían la complejidad técnica de dialectos de IA a especialistas que ya han resuelto el problema.