Inicio/ Blog/ Por qué calibrar modelos de propensión de pago por produc…

Por qué calibrar modelos de propensión de pago por producto y vintage

4 nov 2026 – 11 min de lectura

por Ed Escobar Co-Founder & CEO

La calibración de modelos de propensión de pago es el proceso que asegura que las probabilidades predichas por tu scoring coincidan con las tasas de pago reales. Un modelo descalibrado puede predecir 80% de probabilidad de pago en un segmento que termina pagando solo 50%, destruyendo la asignación de recursos en cobranza.

Este post cubre métricas, procesos y trampas operacionales de la calibración en cobranza.
Qué es la calibración de propensión de pago y por qué importa

Un modelo de propensión de pago asigna a cada deudor un score (0-100 o probabilidad 0-1) que indica la chance de que pague en los próximos N días. Estos modelos usan machine learning supervisado (regresión logística, random forest, gradient boosting, XGBoost) entrenados con variables comportamentales, historial de pago y características de la deuda.

Calibración significa que si tu modelo asigna score=0.85 a 1000 deudores, esperas que ~850 efectivamente paguen. Si solo pagan 600, el modelo está descalibrado: sobreestima en 40%.

Por qué importa:

  • Asignación de canales: Si envías a voice agents solo a deudores con score >0.70 esperando 70% de recuperación, pero la tasa real es 50%, tu ROI cae 30%.
  • Estrategias de negociación: Modelos descalibrados aprueban descuentos excesivos a deudores que pagarían sin incentivo.
  • Cumplimiento: Reguladores revisan que tus modelos de riesgo operacional cumplan estándares (CNBV en México, BCRA en Argentina).

Diferencias de comportamiento por tipo de producto financiero

No todos los productos se comportan igual en cobranza. Un crédito de nó MINA tiene patrones distintos que una tarjeta de crédito o un préstamo hipotecario.

Créditos de nómina

  • Mora temprana baja (15-20%): descuento automático en nómina reduce riesgo.
  • Picos de mora: desempleo súbito, cambio de empleador sin actualizar datos.
  • Propensión alta en mora 0-30 días, colapsa en mora >90.

Tarjetas de crédito

  • Mora temprana alta (30-40%): cliente usa el crédito rotativo, paga mínimos.
  • Sensibilidad a canal: respuesta a WhatsApp 2x mayor que llamadas telefónicas.
  • Propensión de pago volátil: cliente puede pagar esta semana y caer en mora la siguiente.

Préstamos de consumo (fintech/retail)

  • Alta concentración en mora 30-60 días.
  • Propensión correlacionada con fecha de cobro (quincena, fin de mes).
  • Descuentos efectivos: negociar plan de pago mejora recuperación en 25-30%.

Hipotecarios

  • Mora lenta: cliente prioriza la vivienda, mora >180 días es rara.
  • Monto alto, propensión baja en contacto inicial, pero tasas de recuperación final altas (85%+).

Implicación: Un modelo entrenado con mezcla 80% tarjetas + 20% nómina predice mal en carteras hipotecarias puras. Debes entrenar modelos separados o calibrar pesos por producto.

| Producto | Propensión mora 0-30 | Propensión mora 60-90 | Canal óptimo |

|-------------------|----------------------|-----------------------|-------------------|

| Nómina | 0.75 | 0.35 | Voice agent |

| Tarjeta crédito | 0.55 | 0.40 | WhatsApp + voice |

| Consumo fintech | 0.60 | 0.45 | WhatsApp primero |

| Hipotecario | 0.80 | 0.70 | Gestor humano |

(Datos ilustrativos de benchmarks LATAM — tu cartera puede variar.)
Efecto vintage: cómo cambia el riesgo según cohorte de originación

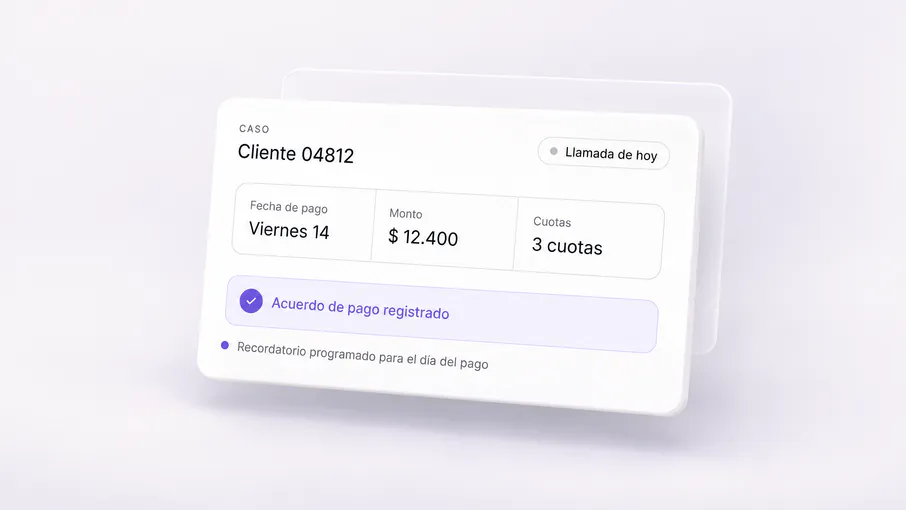
Ilustración de la interfaz de Kleva: ficha de un caso con la fecha de pago, el monto y las cuotas, marcada como acuerdo de pago registrado y con un recordatorio programado.

Vintage (o cohorte de originación) agrupa créditos por fecha de desembolso: enero 2025, Q1 2025, etc. Cada vintage tiene riesgo propio porque:

  1. Condiciones macroeconómicas: créditos originados en recesión tienen mora 10-15% mayor.
  2. Cambios en políticas de originación: si relajaste scoring crediticio en Q2 para crecer volumen, ese vintage tendrá peor desempeño.
  3. Estacionalidad: vintage diciembre (aguinaldo, gastos navideños) vs vintage marzo.

Solución: Calibra modelos estratificando por vintage. En la práctica:

  • Entrena con datos de los últimos 12-18 meses.
  • Valida en ventanas móviles de 3 meses.

Métricas esenciales para validar la calibración del modelo

1. Brier Score

Mide error cuadrático medio entre probabilidades predichas y resultados binarios (pagó / no pagó):

``

Brier = (1/N) * Σ (p_pred - y_real)²

`

  • Score perfecto: 0.00 (nunca en la práctica).
  • Malo: >0.25 → modelo no separa bien.

Ejemplo: Modelo predice p=0.80 para 100 deudores, 70 pagaron:
`

Brier = [(0.80-1)² 70 + (0.80-0)² 30] / 100 = 0.22

`

2. Calibration Plot (Reliability Diagram)

Agrupa predicciones en deciles (0-10%, 10-20%, ..., 90-100%) y compara:

  • Eje X: probabilidad predicha promedio en cada decil.
  • Eje Y: fracción real que pagó.

Línea ideal: diagonal 45° (predicho = observado).

Señales de alerta:

  • Curva por debajo de la diagonal: modelo sobreestima propensión → desperdicias recursos en deudores que no pagarán.
  • Curva por encima: modelo subestima → pierdes recuperación en segmentos buenos.

3. ROC-AUC

Mide capacidad de separar pagadores de no-pagadores, pero NO mide calibración. Puedes tener AUC=0.85 (excelente separación) y estar descalibrado.

Usa ROC-AUC + Brier Score juntos: AUC para ranking, Brier para calibración.

4. Backtesting por segmento

Valida que la calibración se mantenga en:

  • Por producto: tarjeta vs nómina vs consumo.
  • Por vintage: Q1-2024 vs Q2-2024.
  • Por tramo de mora: 0-30, 30-60, 60-90 días.

Si Brier global = 0.14 pero Brier en hipotecarios = 0.28, el modelo falla en ese producto.
Cómo detectar drift y recalibrar modelos en producción

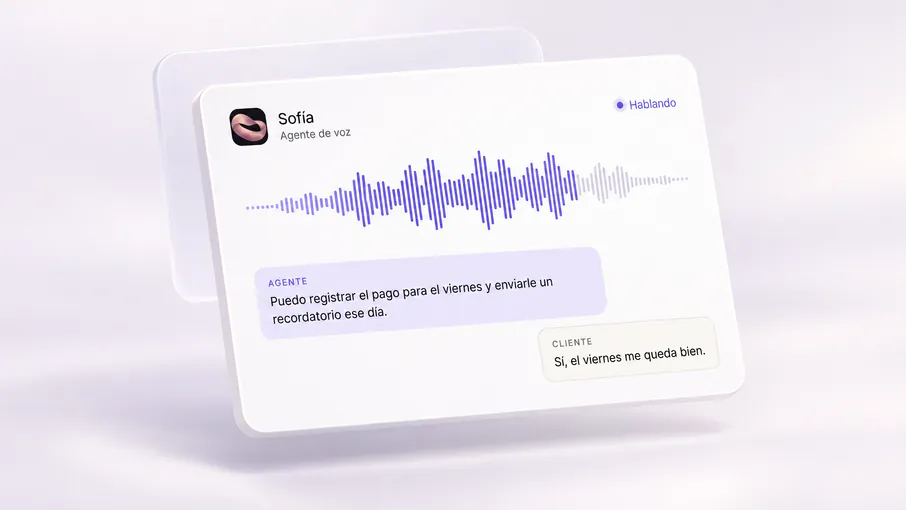
Ilustración de la interfaz de Kleva: la agente de voz Sofía hablando, con la onda de su voz y la conversación en burbujas: la agente propone registrar el pago para el viernes y el cliente acepta.

Drift del modelo ocurre cuando el comportamiento de pago cambia y tu modelo (entrenado con datos históricos) deja de predecir bien. Causas:

  1. Cambios macro: inflación, tasas de interés, desempleo.
  2. Cambios operacionales: nuevo canal de cobranza (WhatsApp), cambio de BPO.
  3. Behavioral shift: deudores aprenden a "jugar" el sistema (ej: prometen pago para pausar contactos).

Señales de drift

  • Brier score sube >5% respecto a baseline.
  • Calibration plot se desvía de la diagonal.
  • Tasa de recuperación baja sin cambio en composición de cartera.

Proceso de recalibración

  1. Monitoreo semanal: calcula Brier score y tasa de pago real vs predicha.
  2. Alerta automática: si desviación >5% por 2 semanas consecutivas → investiga.
  3. Reentrenamiento:
  4. Añade datos de últimos 3 meses.
  5. Valida en vintage más reciente.
  6. Compara Brier nuevo vs anterior en holdout set.
  7. Deploy gradual: aplica modelo nuevo a 20% de cartera, valida 1 semana, escala.

Frecuencia típica:

  • Fintechs LATAM: recalibración mensual (carteras volátiles).
  • Bancos tradicionales: trimestral.
  • Hipotecarios: semestral.

FAQ sobre calibración de modelos de cobranza

¿Cuál es la diferencia entre calibración y accuracy del modelo?

Accuracy mide si clasificas correctamente (pagador/no-pagador). Calibración mide si tus probabilidades predichas coinciden con las tasas reales. Puedes tener 80% accuracy y estar descalibrado. Ejemplo: modelo predice 90% probabilidad para todos los que pagan y 10% para los que no → accuracy alta, pero probabilidades inútiles para decisiones de negocio (¿cuánto descuento ofrecer? ¿qué canal usar?).

¿Con cuántos datos necesito para calibrar por producto y vintage?

Mínimo 5,000 registros por segmento (producto × vintage) para entrenar con confianza estadística. Si tienes menos, agrupa productos similares (ej: consumo + tarjeta) o vintages trimestrales en vez de mensuales.

¿Qué hacer si un producto nuevo no tiene historial suficiente?

Usa transfer learning: entrena modelo base con productos maduros, ajusta con datos limitados del nuevo producto. Alternativamente, aplica modelo de producto "parecido" (ej: nuevo crédito automotriz usa modelo de consumo) y recalibra agresivamente los primeros 3 meses (cada 2 semanas) hasta acumular datos propios.

¿Cómo manejar vintages con eventos macro únicos (ej: pandemia, crisis)?

Excluye vintages atípicos del entrenamiento si no esperas repetición del evento. Ejemplo: vintage marzo-abril 2020 (lockdown COVID) tiene mora 50%+ anómala; usar esos datos distorsiona modelos futuros. Alternativa: crea variable dummy "crisis_period" y entrena con todos los datos, dejando que el modelo aprenda el efecto.

¿Qué software usar para calibración en producción?

Open source: Python + scikit-learn (calibration curves, Brier score), XGBoost/LightGBM para modelos, MLflow para tracking. Comercial: algunas plataformas de cobranza integran calibración automática. Básico: Google Sheets + BigQuery para cálculos manuales (funciona hasta ~50k registros).

Conclusión: La calibración por producto y vintage transforma modelos de propensión de pago de "ranking aproximado" a herramienta de decisión precisa.

En LATAM, donde carteras mezclan productos heterogéneos y vintages volátiles, calibrar es obligatorio para competir. Las plataformas que automatizan esto permiten a equipos de cobranza escalar sin contratar data scientists.

Siguiente paso: Revisa el Brier score de tu modelo actual por producto. Si está >0.20 en algún segmento, tienes oportunidad inmediata de mejora.

Caso práctico: implementar calibración por producto en 4 semanas

Semana 1: Auditoría de datos y segmentación

  1. Extrae historial de cobranza de los últimos 12-18 meses, con las columnas que siguen:
  2. ID deudor, fecha de mora, días en mora, monto adeudado
  3. Producto (tarjeta/nómina/consumo/otro)
  4. Vintage (mes/trimestre de originación)
  5. Outcome binario: pagó en próximos 30 días (1/0)
  6. Variables comportamentales: contactos previos, canal de respuesta, promesas incumplidas
  7. Valida volumen por segmento:

`python

import pandas as pd

df = pd.read_csv('cobranza_historico.csv')

segmentos = df.groupby(['producto','vintage_trimestre']).size()

Filtra segmentos con volumen suficiente

segmentos_validos = segmentos[segmentos >= 5000]

`

  1. Identifica vintages atípicos: Q2-2020 (pandemia), períodos con cambios bruscos en política crediticia. Márcalos para análisis separado.

Semana 2: Entrenamiento de modelos por segmento

  1. Split train/test por tiempo: entrena con meses 1-15, valida en meses 16-18 (nunca split aleatorio — introduce data leakage).
  2. Algoritmo: XGBoost o LightGBM (capturan no-linealidades, manejan valores faltantes).
  3. Entrena UN modelo por producto: tarjeta, nómina, consumo.
  4. Hyperparameter tuning: usa validación cruzada temporal (3 folds, respetando orden cronológico).

Código base:

`python

from xgboost import XGBClassifier

from sklearn.calibration import calibration_curve

import numpy as np

Modelo para tarjetas

X_train_tc = df[(df.producto=='tarjeta') & (df.mes

y_train_tc = df[(df.producto=='tarjeta') & (df.mes

model_tc = XGBClassifier(max_depth=5, n_estimators=200, learning_rate=0.05)

model_tc.fit(X_train_tc, y_train_tc)

Validación

X_test_tc = df[(df.producto=='tarjeta') & (df.mes>15)][features]

y_test_tc = df[(df.producto=='tarjeta') & (df.mes>15)]['pago_30d']

y_pred_proba = model_tc.predict_proba(X_test_tc)[:,1]

Calibration plot

prob_true, prob_pred = calibration_curve(y_test_tc, y_pred_proba, n_bins=10)

Ideal: prob_true ≈ prob_pred (línea 45°)

`

Semana 3: Validación de calibración

  1. Calcula Brier score por producto:

`python

from sklearn.metrics import brier_score_loss

brier_tc = brier_score_loss(y_test_tc, y_pred_proba)

  1. Genera calibration plot: Si la curva está consistentemente por debajo de la diagonal, aplica isotonic regression o Platt scaling para recalibrar:

`python

from sklearn.calibration import CalibratedClassifierCV

model_tc_calibrado = CalibratedClassifierCV(model_tc, method='isotonic', cv='prefit')

model_tc_calibrado.fit(X_val, y_val) # usa un conjunto de validación separado

``

  1. Backtesting por vintage: valida el Brier score en cada vintage.

Semana 4: Deploy gradual y monitoreo

  1. Deploy a 20% de cartera nueva: asigna scoring de modelo calibrado a 1 de cada 5 deudores nuevos.
  2. A/B test vs modelo anterior: compara recuperación, costo por contacto, tasa de promesas cumplidas.
  3. Dashboard de drift: calcula semanalmente las métricas que siguen:
  4. Brier score en producción vs baseline
  5. Tasa de pago real vs predicha (global y por decil de score)
  6. Alerta automática: si Brier sube >5% o desviación predicho/real >10% → activa revisión.
Volver al índice ↑
FAQ

¿Tienes preguntas?

Seguir leyendo
Tu siguiente paso

Más tiempo para resolver. Menos llamadas pendientes.

Ve qué llamadas y seguimientos puedes delegar. Decide con tu equipo qué quieres mejorar y cómo medirlo.

Solicitar demo